Infino将搜索索引放在对象存储上的设计
What changes when your search index lives on S3?
中文摘要
由模型生成 · 人工抽检Infino 把全文与向量索引构建在 S3 等对象存储上,针对每次随机读都是网络往返这一约束,采用单文件 superfile、内联 footer 的 manifest、term index 与按字节范围懒加载,把冷查询的 GET 次数从多次降到一次甚至零次。
全文
已译中文约 11 分钟读完当你的搜索索引存放在 S3 上时,会发生哪些变化?
2026 年 10 月 15 日 · 工程
关于 Infino 如何构建的系列文章第 1 部分。
在 Infino,我们正在构建一个检索引擎,以大规模地回答智能体的问题,其全文搜索是现有最快的之一 [1]。智能体会查询结构化、半结构化和非结构化数据,因此我们需要支持 SQL、向量搜索、BM25 全文搜索,以及这些查询形态之间的任意组合。在大多数情况下,数据已经存放在对象存储中,这保证了可扩展性和高可用性。因此,我们决定在对象存储上构建搜索索引,支持 S3、GCS 和 Azure Blob Storage。
搜索引擎传统上将其索引保存在本地磁盘上。Lucene——大多数搜索引擎都构建于其上或以其为模型——假设索引位于 CPU 旁的磁盘上,在那里随机寻道相对廉价。然而,当你把索引迁移到对象存储时,情况并非如此,因为每一次随机读取都是一次网络往返。在本文中,我们描述了因此而在设计上做出的一些不同决策。
架构
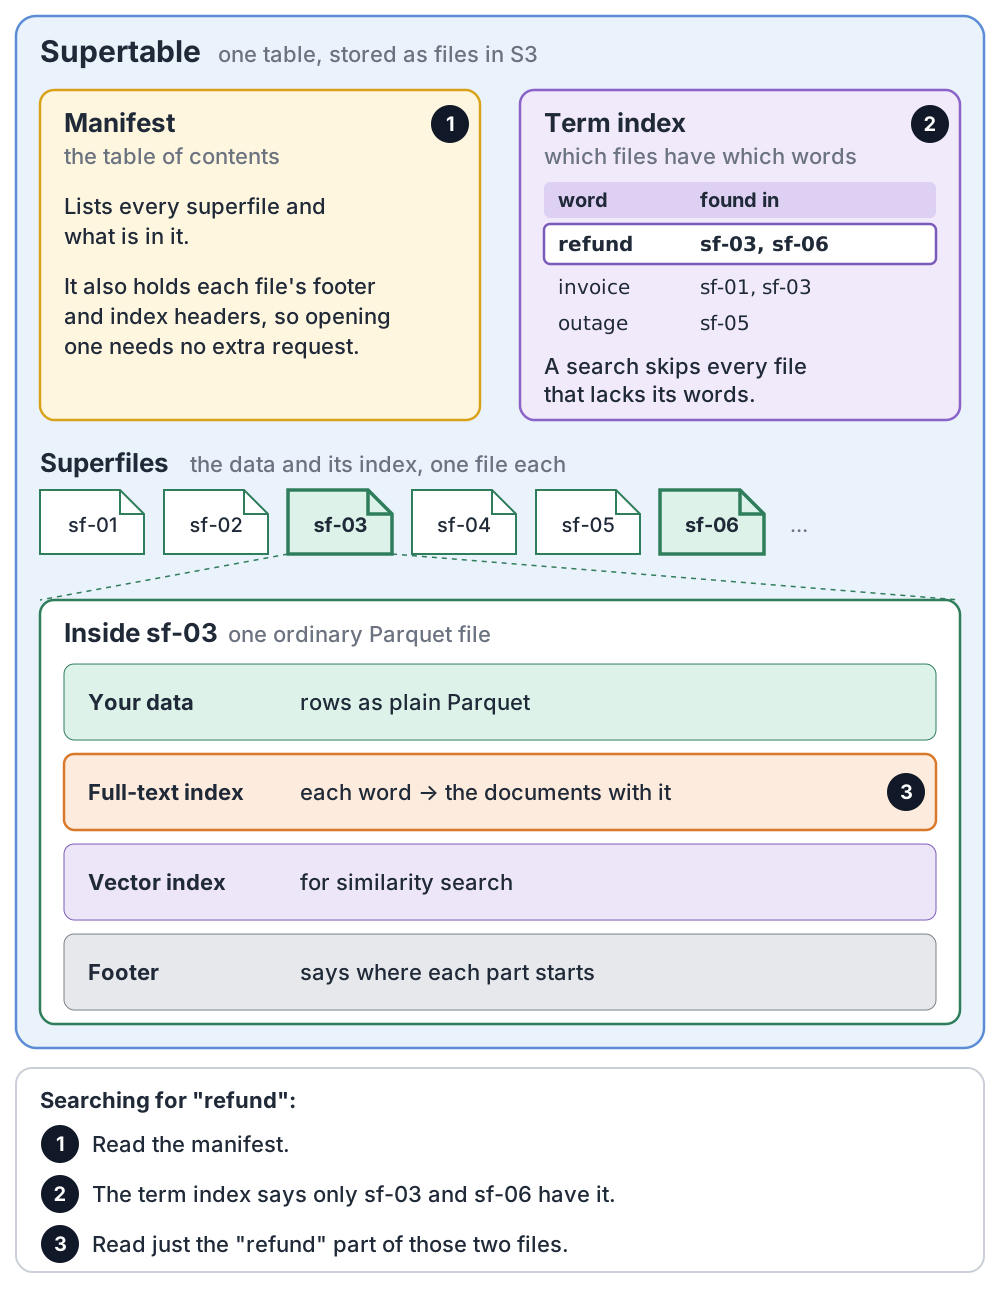
Infino 将数据组织成 superfiles,即带有 Infino 全文索引和向量索引的 Parquet 文件。许多 superfiles 组成一个 supertable。每个 supertable 拥有 (a) 一个 manifest,其中列出 superfiles 及其 footer 和索引头,外加列统计信息,以及 (b) 一个 term index,其中列出词项及其出现在哪些 superfiles 中,以及得分边界信息。
成本模型
在本地 SSD 上,如果页面已被缓存,随机读取不产生任何成本;若发生缺页,成本也不到一毫秒。因此,索引位于 SSD 上的搜索引擎可以随意进行大量随机读取。而在 S3、GCS 或 Azure Blob 上,每次随机读取都是一次 HTTP GET 请求,通常需要几十毫秒,并且按请求次数以美元计费,无论返回多少字节。这改变了在对象存储上构建搜索引擎时需要优化的对象。最稀缺的资源不是 CPU,也不是字节数,而是你对对象存储发起的往返次数,下面的大多数设计决策都由此而来 [2]。
每个索引单元一个文件
搜索索引以不可变单元的形式构建。你摄入一批文档,引擎就会为它们写入一个自包含的索引。更新同样以新单元的形式写入,随后由后台合并进程将旧单元合并为新的不可变单元。在 Lucene 中,这个不可变单元称为 segment;在 Infino 中,它称为 superfile。Infino 所使用的索引数据结构是后续文章的主题,但好奇的读者可以在这里了解它们:superfile 架构。
一个 Lucene segment 是一组文件:词项字典(.tim)、词项字典的索引(.tip)、倒排列表(.doc)、位置信息(.pos)等等。默认情况下,Lucene 会将较小的 segment 打包进一个复合文件(.cfs,并在 .cfe 中保存条目表),而较大的 segment 则保留各自独立的文件。无论哪种方式,在对象存储上打开一个 segment 都需要多次 GET 请求。
一个 Infino superfile 始终是单个对象:一个普通的 Parquet 文件。文档就是普通的行组(row group),全文索引和向量索引则以字节区域的形式拼接在 Parquet footer 之前,通过 footer 元数据中的键来定位。DuckDB、PyArrow 或任何其他 Parquet 读取器都可以将这个文件作为普通 Parquet 文件读取。由于每个区域的字节偏移量都记录在元数据中,superfile 的任意区域都可以通过一次范围 GET 请求获取。
清单(manifest)
每个超级表都有一个清单(manifest),其中列出构成该超级表的超级文件(superfile)。一次写入会创建新的超级文件,写入包含这些新文件的新清单,然后原子地将一个小指针文件切换到新清单,因此读者始终能看到一组一致的超级文件。
全文索引和向量索引的字节偏移量存储在 Parquet footer 中,即超级文件的末尾。全文索引还有一个小头部,读者在查找任何词项之前需要先读取它。如果查询要从每个超级文件中读取这些内容,那么在任何搜索工作开始之前,每个超级文件都会额外产生一次 GET 请求。因此,清单会内联存储每个超级文件的 Parquet footer 和索引头部。清单通常会被缓存,而且由于它已经包含 Parquet footer 和索引头部,打开一个超级文件完全不需要 GET。查询对超级文件发出的第一次 GET 获取的是它真正需要的数据,例如某个词项的倒排列表(postings)。这将每个超级文件的冷启动成本从两次往返降低为一次。
清单还存储每个超级文件的列统计信息,例如每一列的最小值、最大值和空值计数。带有 created_at > '2026-10-01' 这类过滤条件的查询可以跳过最大 created_at 早于该值的超级文件,而无需打开它。然而,列统计信息无法判断某个超级文件是否包含单词“refund”,这正是下一节所述的词项索引的用途。
词项索引
如果没有词项索引,全文查询就必须逐个询问每个 superfile 是否包含查询的词项。这需要读取每个 superfile 的词项字典,也就是说每个 superfile 至少需要一次 GET 请求,即使最终发现该 superfile 根本不包含该词项也是如此。一个 supertable 可能包含数千个 superfile,因此这样做的开销很快就会变得很高。
因此,每个 supertable 还拥有一个词项索引,其中列出每个词项以及它出现于哪些 superfile 中。对于每个词项和 superfile,它存储:(a) 该 superfile 中包含该词项的文档数量;(b) 一个分数上界,即该词项能为该 superfile 中任意文档给出的最高 BM25 分数;(c) 该词项倒排列表在 superfile 内的字节偏移量。词项索引按词项范围切分为多个分片,因此查询只会获取包含其词项的那些分片,而不是整个索引。
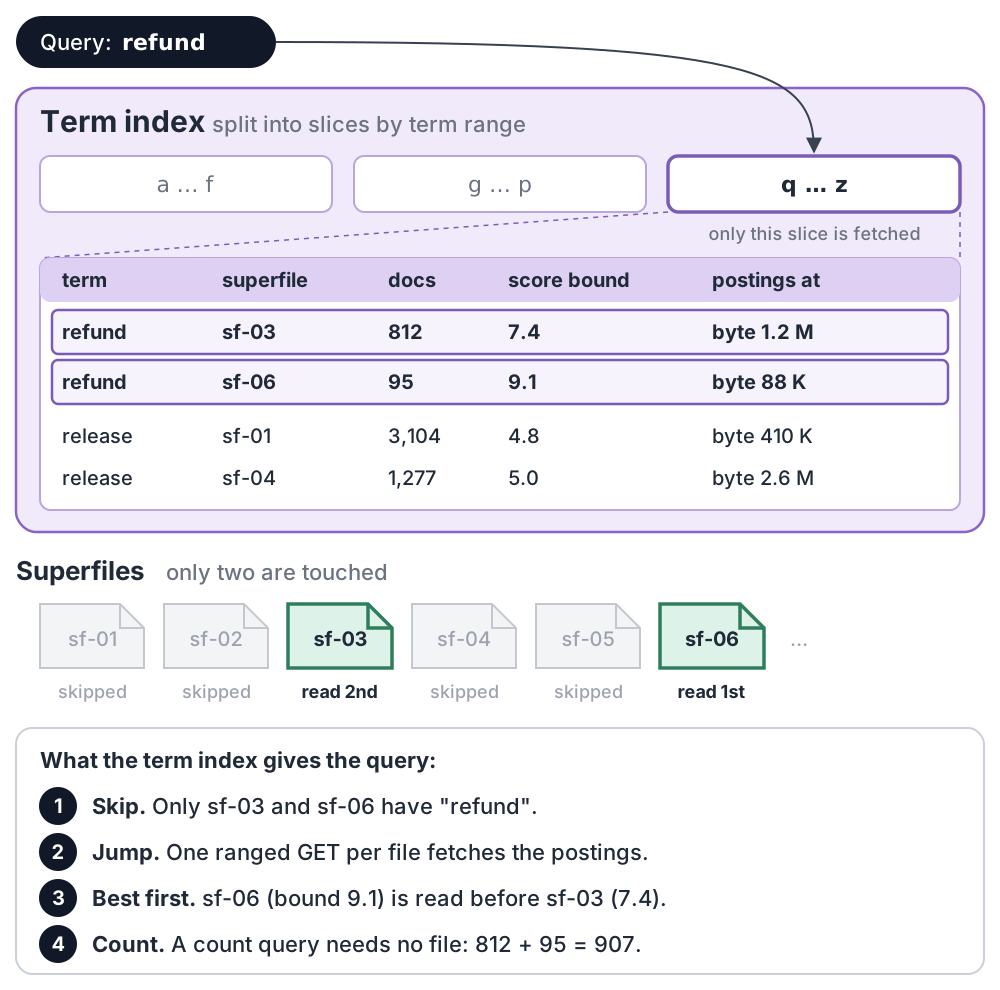
有了这个,对“refund”的查询会先在词项索引中查找“refund”,发现只有 sf-03 和 sf-06 包含它。它会跳过其他所有超级文件,而不打开它们。由于词项索引还记录了倒排列表的字节偏移量,查询只需对 sf-03 和 sf-06 各发起一次范围 GET 请求即可获取“refund”的倒排列表,而无需读取它们的词项字典。
文档计数和分数上界同样有帮助。对于 top-k 查询,查询会按分数上界降序访问超级文件,一旦某个超级文件的分数上界低于目前已找到的第 k 个最佳分数,就跳过该超级文件。针对单个词项的计数查询可以仅凭文档计数来回答,而无需打开任何超级文件 [3]。在我们的一项测试中,对一个包含 141 个超级文件的超级表进行单词项计数,从需要打开 141 个超级文件变为一个都不需要打开。同样的文档计数还为 BM25 提供了评分所需的语料库级统计信息。
词项索引在每次提交时都会保持最新:添加超级文件的提交也会将其词项追加到词项索引中,而后台的优化步骤会定期将这些新增内容合并为一个紧凑的索引。
只读取所需内容
…
本译文由模型自动生成,仅供参考与快速理解;涉及数字、版本、命令、法律条文等请以原文为准。
原文附件
1 个 · 均跳转原站,本站不托管文件正文为原站公开内容的抓取与清洗结果,英文条目附模型生成的中文译文;两者均仅供参考, 准确内容请以原站为准。内容版权归原作者所有,若认为侵权请联系我们下线。