Learning the importance of training data under concept drift
中文摘要
由模型生成 · 人工抽检谷歌研究提出实例条件衰减时间尺度方法,为每个训练样本学习重要性分数,解决概念漂移下新旧数据相关性差异问题。在3900万张照片的十年基准上,相对准确率提升达15%,优于在线与持续学习。
全文
已译中文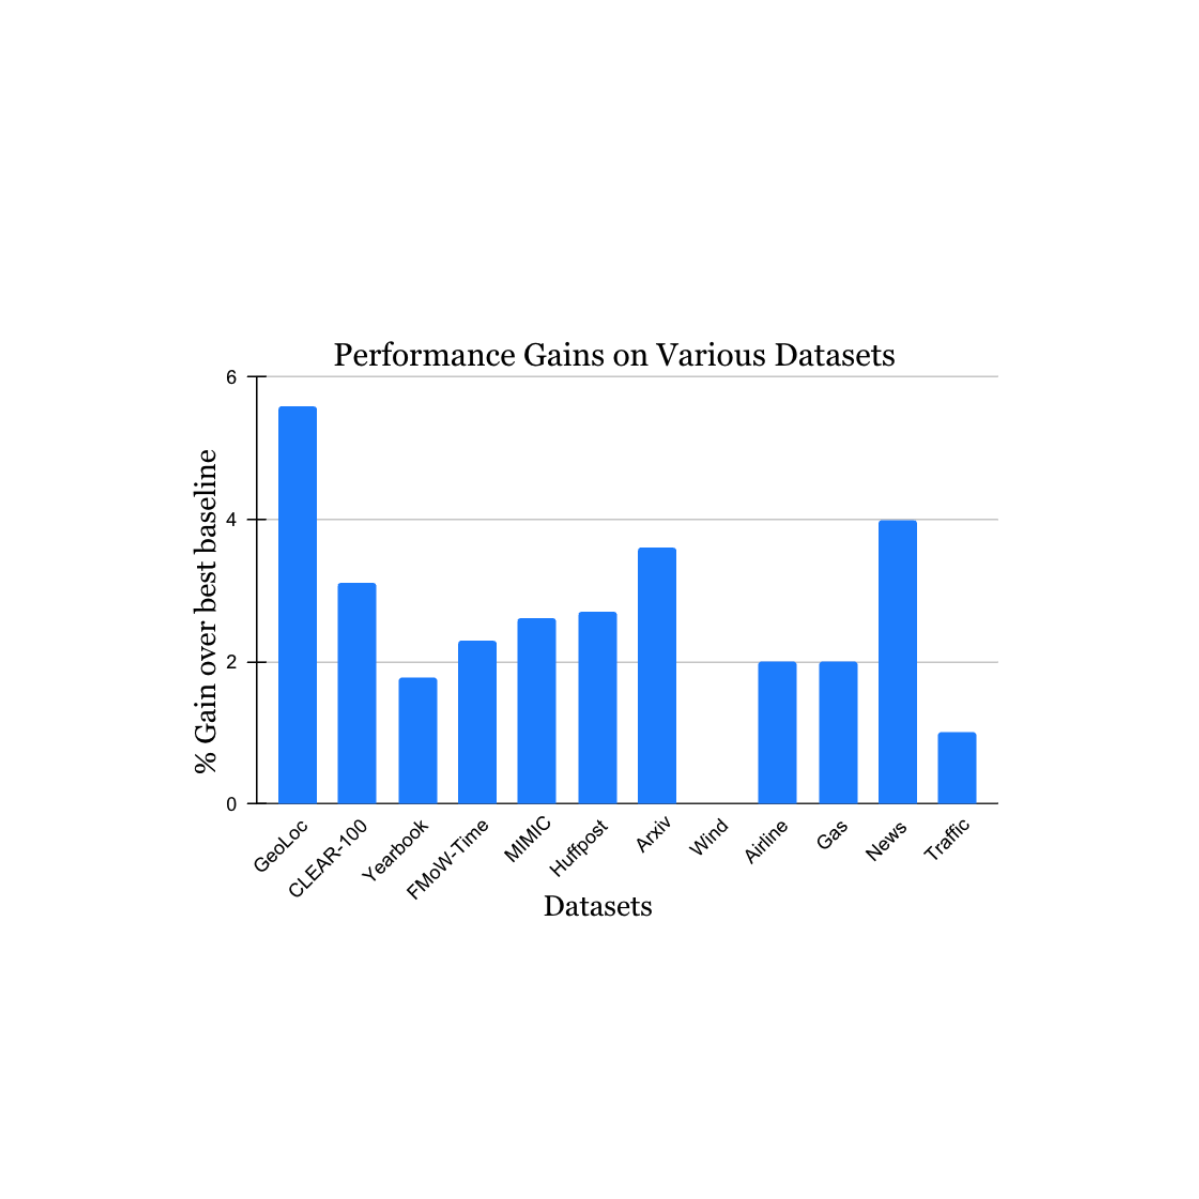
我们周围世界不断变化的本质给 AI 模型的开发带来了重大挑战。通常,模型在纵向数据上训练,期望所使用的训练数据能准确代表模型未来可能接收到的输入。更普遍地说,所有训练数据同等相关这一默认假设在实践中往往不成立。例如,下图展示了 CLEAR 非平稳学习基准测试中的图像,它说明了物体的视觉特征在 10 年跨度内如何显著演变(我们将这一现象称为缓慢概念漂移),这给物体分类模型带来了挑战。
 |
|---|
| Sample images from the CLEAR benchmark. (Adapted from Lin et al.) |
|---|
其他方法,例如在线学习和持续学习,会不断用少量近期数据更新模型以保持其时效性。这隐含地优先考虑近期数据,因为从过去数据中学到的知识会被后续更新逐渐抹去。然而在现实世界中,不同类型的信息以不同的速率失去相关性,因此存在两个关键问题:1)从设计上,它们完全聚焦于最新的数据,并丢失了被抹去的旧数据中的任何信号。2)数据实例的贡献随时间均匀衰减,而与数据内容无关。
在我们最近的工作“用于非平稳学习的实例条件时间尺度衰减”中,我们提出在训练期间为每个实例分配一个重要性分数,以最大化模型在未来数据上的性能。为实现这一点,我们采用一个辅助模型,利用训练实例及其年龄来生成这些分数。该模型与主模型联合学习。我们解决了上述两个挑战,并在多个非平稳学习的基准数据集上相较于其他鲁棒学习方法取得了显著提升。例如,在一个近期的大规模非平稳学习基准测试(约3900万张照片,跨越10年时间)上,我们通过学习的训练数据重加权展示了高达15%的相对准确率提升。
监督学习面临的概念漂移挑战
为了定量地理解缓慢的概念漂移,我们在一个近期的照片分类任务上构建了分类器,该任务包含约 3900 万张来自社交媒体网站、时间跨度达 10 年的照片。我们比较了离线训练与持续训练:前者以随机顺序对全部训练数据迭代多次,后者则按顺序(时间)顺序对每个月的数据迭代多次。我们在训练期间以及随后的一个阶段(此时两个模型均被冻结,即不再根据新数据进一步更新)测量了模型准确率(如下图所示)。在训练期结束时(左图,x 轴 = 0),两种方法所接触的数据量相同,但表现出很大的性能差距。这是由于灾难性遗忘,这是持续学习中的一个问题,即模型对训练序列早期数据的知识会以不受控制的方式被削弱。另一方面,遗忘也有其优势——在测试期(如右图所示),持续训练的模型比离线模型退化得慢得多,因为它对旧数据的依赖更少。两个模型在测试期的准确率衰减证实了数据确实随时间在演变,并且两个模型都变得越来越不相关。
 |
|---|
| Comparing offline and continually trained models on the photo classification task. |
|---|
训练数据的时间敏感重加权
我们设计了一种方法,结合了离线学习(有效复用所有可用数据的灵活性)和持续学习(淡化旧数据的能力)的优势,以应对缓慢的概念漂移。我们以离线学习为基础,然后对历史数据的影响和优化目标进行精细控制,两者都旨在减少未来的模型衰减。
假设我们希望训练一个模型 M,给定随时间收集的一些训练数据。我们提出同时训练一个辅助模型,该模型根据每个数据点的内容和年龄为其分配权重。该权重在 M 的训练目标中缩放该数据点的贡献。权重的目标是提高 M 在未来数据上的性能。
在我们的工作中,我们描述了如何对辅助模型进行元学习,即在与M一同学习的过程中,以一种有助于模型M自身学习的方式进行学习。辅助模型的一个关键设计选择是,我们以因子化的方式分离出与实例相关的贡献和与年龄相关的贡献。具体而言,我们通过组合来自多个不同的固定时间尺度衰减的贡献来设定权重,并学习将给定实例近似“分配”到最适合它的时间尺度。我们在实验中发现,这种形式的辅助模型优于我们考虑过的许多其他替代方案——从无约束的联合函数到单一时间尺度的衰减(指数或线性)——这得益于它在简洁性与表达能力之间的结合。完整细节可在论文中找到。
实例权重评分
下图展示了我们学习到的辅助模型确实在 CLEAR 物体识别挑战赛中为看起来更现代的物体赋予了更高的权重;看起来更古老的物体则相应地被降低了权重。进一步考察(下图,基于梯度的特征重要性评估)后,我们发现辅助模型关注的是图像中的主要物体,而非例如可能与实例年龄产生虚假相关性的背景特征。
 |
|---|
| Sample images from the CLEAR benchmark (camera & computer categories) assigned the highest and lowest weights respectively by our helper model. |
|---|
 |
|---|
| Feature importance analysis of our helper model on sample images from the CLEAR benchmark. |
|---|
结果
大规模数据上的收益
我们首先研究之前讨论过的、在 YFCC100M 数据集 上的大规模照片分类任务(PCAT),使用前五年的数据进行训练,并将后五年作为测试数据。我们的方法(下图中以红色显示)相较于无重加权基线(黑色)以及许多其他鲁棒学习技术都有显著提升。有趣的是,我们的方法有意牺牲了对遥远过去(训练数据未来不太可能再次出现)的准确率,以换取测试阶段的显著改进。此外,正如预期的那样,我们的方法在测试阶段的性能下降幅度小于其他基线。
 |
|---|
| Comparison of our method and relevant baselines on the PCAT dataset. |
|---|
广泛适用性
我们在来自学术文献的大量非平稳学习挑战数据集上验证了我们的发现(详情参见 1、2、3、4),这些数据集涵盖多种数据来源与模态(照片、卫星图像、社交媒体文本、医疗记录、传感器读数、表格数据)以及多种规模(从 1 万到 3900 万个实例不等)。与每个数据集最接近的已发表基准测试方法相比,我们在测试阶段报告了显著的提升(如下所示)。请注意,此前已知的最佳方法可能因数据集而异。这些结果展示了我们方法的广泛适用性。
 |
|---|
| Performance gain of our method on a variety of tasks studying natural concept drift. Our reported gains are over the previous best-known method for each dataset. |
|---|
对持续学习的扩展
最后,我们考虑本工作一个有趣的扩展方向。上文描述了如何借助受持续学习启发的思路,将离线学习扩展以应对概念漂移。然而,有时离线学习并不可行——例如,当可用的训练数据量过大而难以维护或处理时。我们以直接的方式将我们的方法适配到持续学习:在用于顺序更新模型的每个数据桶的上下文内应用时间重加权。这一方案仍然保留了持续学习的一些局限性,例如,模型更新仅在最新数据上进行,且所有优化决策(包括我们的重加权)都仅在该数据上做出。尽管如此,在照片分类基准测试(见下文)上,我们的方法始终优于常规持续学习以及广泛的其他持续学习算法。由于我们的方法与这里比较的许多基线中的思路是互补的,我们预计当与它们结合时能获得更大的收益。
 |
|---|
| Results of our method adapted to continual learning, compared to the latest baselines. |
|---|
结论
我们通过结合以往方法的优势——离线学习对数据的有效复用,以及持续学习对更新近数据的侧重——解决了学习中的数据漂移挑战。我们希望我们的工作有助于在实践中提升模型对概念漂移的鲁棒性,并在解决普遍存在的缓慢概念漂移问题上激发更多兴趣和新思路。
致谢
我们感谢 Mike Mozer 在本工作早期阶段进行的许多有趣讨论,以及在其发展过程中提供的非常有帮助的建议和反馈。
本译文由模型自动生成,仅供参考与快速理解;涉及数字、版本、命令、法律条文等请以原文为准。
原文附件
3 个 · 均跳转原站,本站不托管文件正文为原站公开内容的抓取与清洗结果,英文条目附模型生成的中文译文;两者均仅供参考, 准确内容请以原站为准。内容版权归原作者所有,若认为侵权请联系我们下线。