用PyTorch实现0/1背包问题
0/1 Knapsack Problem in PyTorch
中文摘要
由模型生成 · 人工抽检介绍如何用PyTorch张量运算与自动微分求解经典0/1背包问题,展示深度学习框架在组合优化上的通用性,为算法工程师提供跨领域工具复用思路。
全文
已译中文约 10 分钟读完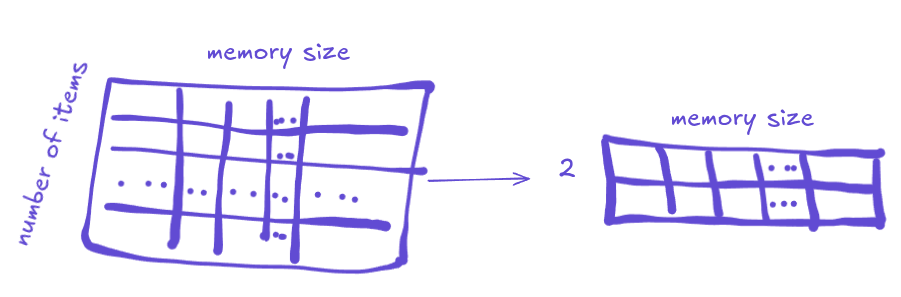
是什么?
当 PyTorch 为你的机器学习模型构建计算图时,它会尝试许多不同的方法来使其快速且内存高效。其中一种技术是取一个联合的前向和反向计算图,并选择哪些操作应该被保存(存储在内存中并复用),哪些操作应该被重新计算。每个操作运行都需要一些时间,如果被存储则会占用一些内存,而我们只能使用有限的内存。
0/1 背包问题
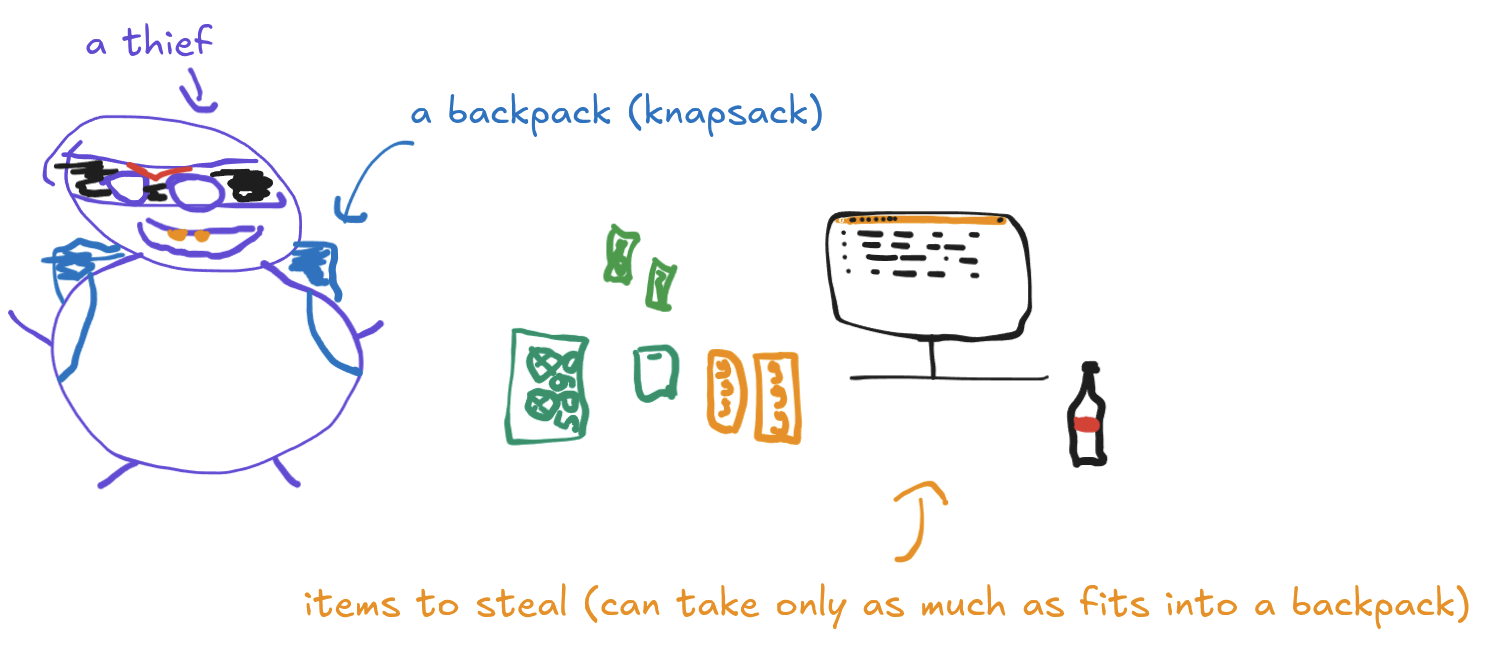
想象你是一个小偷,刚刚闯入一个里面有许多贵重物品的地方。你有一个最多能装 10 公斤的背包。你想最大化你偷到的物品的价值。理想情况下,你会把它们全部拿走。但如果你往背包里装入超过 10 公斤的东西,它就会破裂,你将一无所获。或者,你可以使用一些启发式方法来挑选物品(比如只拿小件物品或只拿绿色的物品),但那样你的方案可能不是最优的——你会偷到一些价值,但也许比最优选择所能获得的价值要少。为了拯救你,0/1 背包求解器应运而生。有不同的算法可以在给定容量(背包中物品的最大重量)和给定物品列表(其中每个物品都有一个价值和一个成本(重量))的情况下计算出最优的物品选择。在 PyTorch 中,我们实际做的就是这件事,即:在 RAM 预算(背包容量)内,我们选择哪些操作(物品)应该被保存到内存中,以最大化运行时的节省时间(价值)。
dp_knapsack
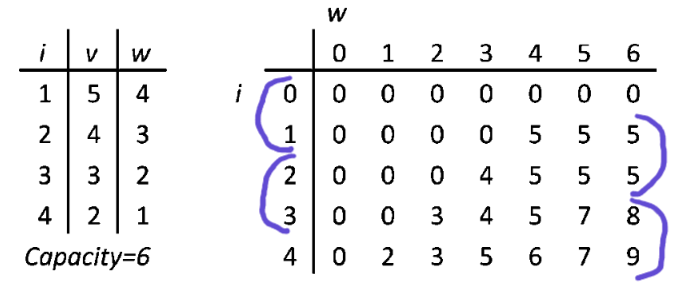
目前,PyTorch 中背包求解器的默认实现是 dp_knapsack,它是一种求解 0/1 背包问题的动态规划方法。一旦理解了它,这个算法其实很简单。如果你之前有过动态规划的经验(我没有),那会很有帮助。看看维基百科上这张不错的 GIF:
 作者 RDSEED - 原创作品,CC BY-SA 4.0,链接
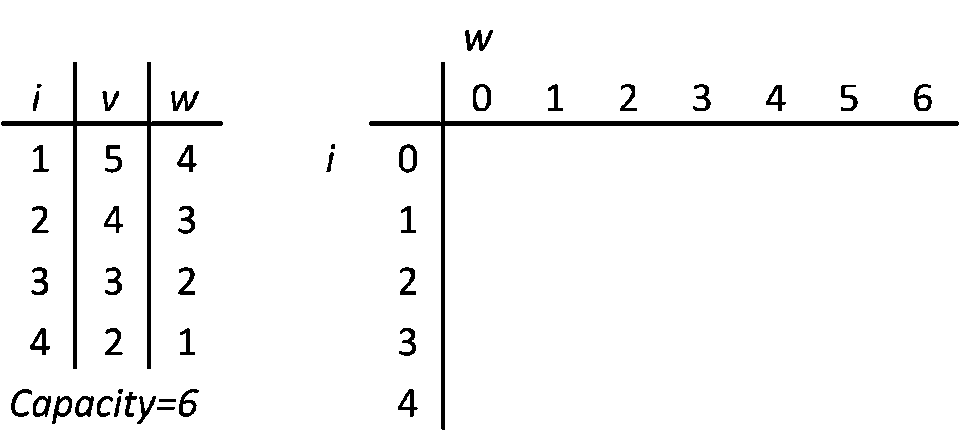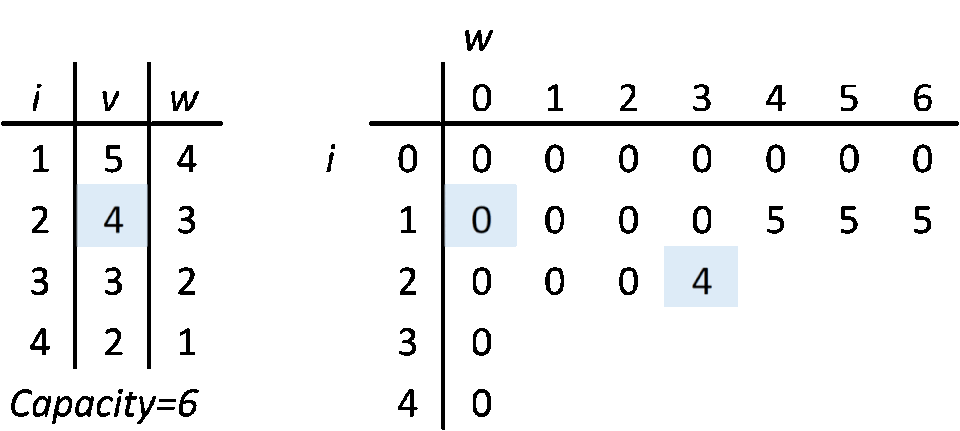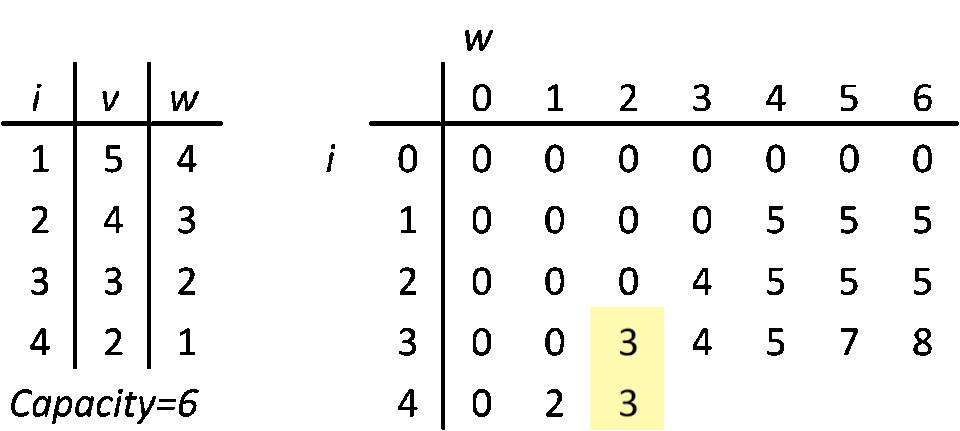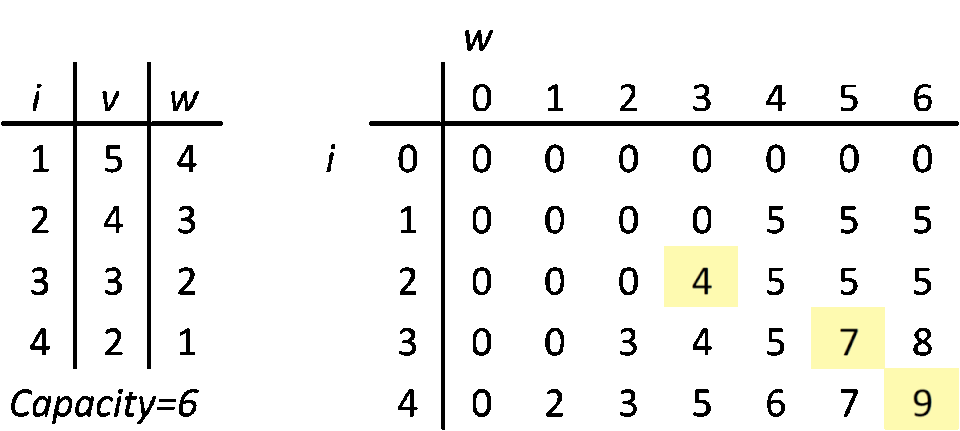
左侧是一个包含 4 个物品的列表。i 是索引,v 是价值,w 是重量。单位无关紧要。容量为 6。这就是为什么右侧有 6 列(每一列代表总容量的一部分)和 4 行(每个物品一行)。好吧,实际上有 7 列和 5 行,因为用零做了填充,但这只是为了计算方便(每一行和每一列都有一个父级,索引运算会容易得多)。你其实可以不做填充,但我试过之后还是回退到了填充,因为索引运算有点烦人。右侧的表格称为 DP 表。计算就发生在这里。
构建 DP 表
DP 0/1 背包算法是这样的:取一个物品。在 DP 表中,逐列遍历对应的一行,将物品的价值与当前 DP 表单元格中的值进行比较(行、列;当前列索引即当前背包的最大重量(容量))。如果物品的重量大于当前列的索引,则继续下一列。如果物品重量等于列索引,且物品价值高于当前单元格,则用物品价值替换该单元格。如果物品重量小于列索引,且能放入剩余容量中,则将其加入该单元格的值(剩余容量即当前容量减去已选物品的容量)。重复此过程,直到遍历完所有物品。此时,你就知道了在重量预算内能获得的最大价值。如果我们的目标只是衡量最大可能价值,那么到此就可以停止。遗憾的是,我们想知道更多。
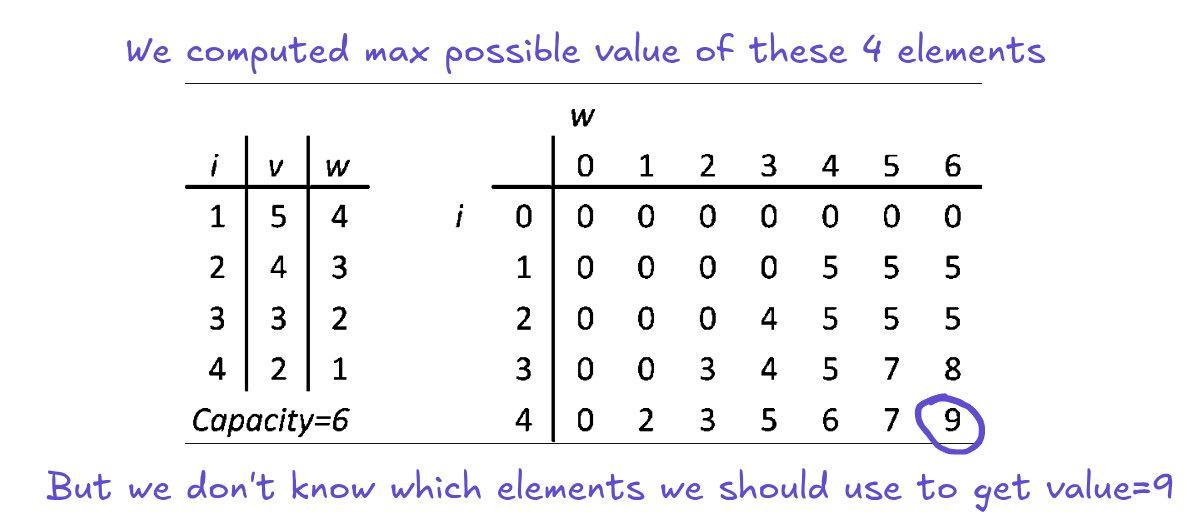
回溯
我们需要知道应该选取哪些物品才能得到这个最大可能价值。因此,在 PyTorch 的情况下,就是哪些操作应该保存到内存中,哪些操作应该重新计算。为了找出哪些物品对最大值有贡献(换句话说,在构建 DP 表的过程中哪些物品被选中),我们需要沿着 DP 表反向遍历。我们从最后一行和最后一列向上走。我们将一个单元格与其上方(同一列、上一行)的单元格进行比较。如果它们不同,那么当前物品对最大值有贡献——因为每一行对应单个物品。如果它们相等,这个物品将不会被存储到内存中,并成为可重新计算的。现在,我们向上遍历 DP 表。如果该物品被选中,我们向上移动一行,并将当前单元格的位置向左移动所选物品的重量。如果物品未被选中,我们向上移动一行,并从与之前相同的位置开始。重复此过程,直到到达 DP 表的顶部。
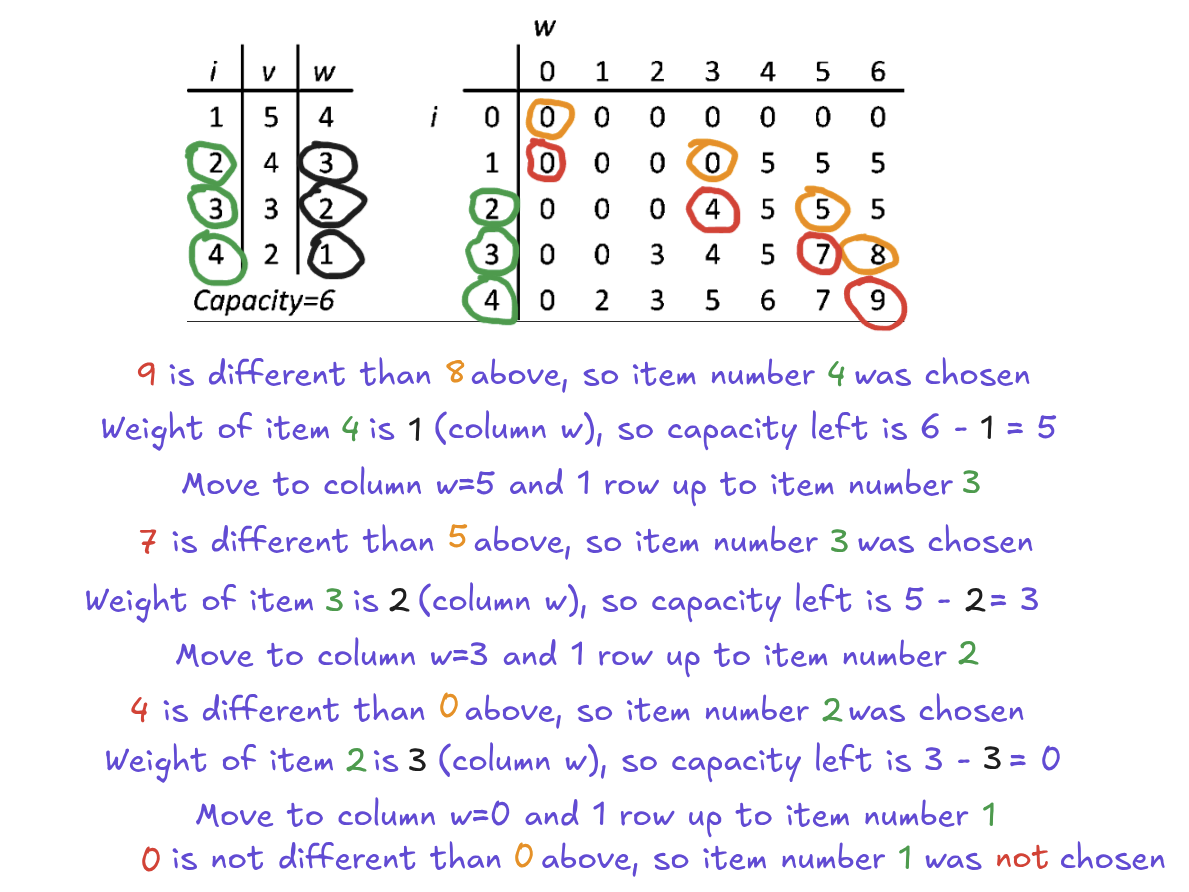
优化
这个求解器工作正常。它提供了精确解,大多数时候你不需要更好的方案。所谓更好,我指的是 1. 更快,2. 更省内存。因为再仔细看看上面的算法和 GIF 图。它存在几个问题。为了得到结果,我们分配了一个形状为 shape=(物品数量, max_weight) 的完整二维表,这并不理想。Horace He (Chillee) 最初构建了 PyTorch 中很大一部分(也许是全部?)的内存规划,他在 DP 背包求解器代码中留下了一条注释:
TODO(chilli): I think if needed, this memory can be optimized with sliding # window trick + Hirschberg trick: # https://codeforces.com/blog/entry/47247?#comment-316200
他提出的是两项优化。
滑动窗口
窗口技巧的意思是,我们不再构建一个 DP 表,而是在一个表上滑动,只使用上一行和当前行。当移动到下一行时,下一行成为新的当前行,旧的当前行成为上一行。如果我们只想在给定容量下计算列表中物品的最大价值,仅这一项改进就足够了。但同样,我们需要知道哪些物品对达到这个最大价值有贡献。这就是 Horace 建议将滑动窗口与 Hirschberg 技巧结合使用的原因。
Hirschberg 技巧
这是一种分治方法,有点类似快速排序,因为你把问题拆分成更小的子问题并逐一求解,不断拆分直到解决整个问题。对我们来说,Hirschberg 技巧的主要好处是它消除了回溯。
从实现的角度来看,我在这里算是做了递归,但没有在栈上压入新的栈帧。我用一个 Python 列表作为显式栈(后进先出)。该列表存储一个物品索引区间和当前可用的容量。我们从所有物品和全部容量开始。然后算法是这样进行的:首先,从栈中弹出一个元素。如果它是单个物品(物品索引区间 end - start = 1),检查该物品的重量是否能装入可用容量。如果能,就把它加入已保存物品;如果不能,就把它加入可重算物品。在我看来,这部分正是 Hirschberg 算法对我们最大的优势——因为你现在可以看到,我们不再需要回溯,因为我们在算法内部就构建了已保存和可重算列表。无需像原始 0/1 DP 背包算法那样在事后构建。如果物品区间大于 1,就把物品分成两部分,并为每一部分计算一张 DP 表。我们不想构建完整的 DP 表,所以这里采用滑动窗口技巧,复用当前行和前一行 DP 来计算最终的 DP 行。
当我们同时得到左、右两行动态规划(DP)结果后,将它们相加。找到最大值所在的位置。它将成为我们内存的新分割点。现在,我们使用这个新计算出的位置将内存一分为二,并在内存和物品都已分割的情况下再次运行算法。重复此过程直到完成。顺便说一句,可能会出现分割后其中一部分为空的情况。当最佳分割点是第一个或最后一个物品时,就可能发生这种情况。这完全合理,我们只需跳过这样的栈帧并继续即可。
…
本译文由模型自动生成,仅供参考与快速理解;涉及数字、版本、命令、法律条文等请以原文为准。
原文附件
1 个 · 均跳转原站,本站不托管文件正文为原站公开内容的抓取与清洗结果,英文条目附模型生成的中文译文;两者均仅供参考, 准确内容请以原站为准。内容版权归原作者所有,若认为侵权请联系我们下线。