My old job feels distant now
全文
已译中文约 11 分钟读完我过去的工作如今感觉非常遥远
2026年10月15日 / 人类撰写 / 1c939998
南瓜放在响尾蛇岩上
我几乎记不清第一次体验 ChatGPT 的情形了。它已经如此深入地融入我的职业生活,以至于要回溯最初的那一刻、或那几个时刻,都变得困难。留下的只是几个片段交织成的模糊印象。某个时刻,我意识到它是一个更好的 Google。这很像当年 StackOverflow 崛起时的情形,Google 搜索编程主题的结果从毫无用处变得有用。搜索不到结果反而意味着“你用错了”的时刻。我记得曾摆弄它,然后记得 Bryan 一直唠叨我“你问过 ChatGPT 了吗?”,让我不胜其烦。直到我不再烦,而它成了我的默认起点。
下一阶段很快就来了。我开始复制粘贴代码,通常是我懒得手写的 Ruby spec。我会描述惯用法,或者粘贴一些示例代码加上我的新行为,让它吐出代码。这比在 IDE 里敲代码快得多,那个 IDE 并没有我习惯的、在真正的强类型语言里那样的代码补全。抱歉,我一直讨厌写 Ruby。也许我最终会像那些 Rails 爱好者一样写得很快。但我无法想象这样的未来,而 ChatGPT 提供了一个逃生出口。我职业早期用过的五六种语言,我都以某种方式学会了喜爱并高效使用。但我已经到达了极限,如今觉得有理由拖延把它学得更好。
接下来的时刻成对出现:Tab 补全和在新领域使用复制粘贴。Tab 补全更自然一些。有时有用,有时没用。它的关键之处在于如何集成到我早已熟悉的 IDE——vscode——之中,并被分叉进 Cursor。它能做的,基本上只是接续我写下的模式;我很少、甚至几乎从不依赖它的智能或实际建议。
对于真正的建议,我仍然在复制粘贴 ChatGPT。但这次不同了。以前它只是一个更复杂的自动补全。现在我在一个新领域里融合了 Google 搜索 + 代码生成:Python 计算机视觉。我转到了一个临时的视觉项目(新物体的边界和对齐);对此我一无所知。我以最快的速度“搜索”,把回复转化为代码。这是我最喜欢的阶段之一,在后来 Opus 模型那种冗长输出之前。ChatGPT 会以我喜欢的方式吐出代码。有时我只需要一个提示、一个特定的 API 或一行代码片段。向它倾泻一堆话,拿回一行代码,而且常常还附带着我要求的俏皮嘲讽。我会在 Jupyter notebook 里运行代码,然后修修改改,生成可视化图像、散点和图表;同时在构建东西的过程中学习 API 和领域知识。这也是我接触幻觉最多的时期,并发现它们是多么容易被检测和处理。对我来说,它成了 ChatGPT 知道什么、不知道什么的信号;幻觉出现在边界处,轮到我填补空白,弄清楚那些文档较少、或者可能是我们用例独有的东西是如何运作的。有时候进展缓慢,但我几乎无法想象没有它的情况下跳进一个计算机视觉项目并如此快速地交付成果。这是一个令人愉悦的未来;更多的是关于消除 SEO 垃圾信息和未类型化语言(这些更依赖好的文档)上写得糟糕的文档,而不是一个我放弃控制权的未来。
智能体编程紧接着就来了。我至今仍清楚地记得读到《Snorting the AGI》和Karpathy 那句著名调侃时的情形,当时还有点惊讶。这些人到底在说什么?但慢慢地,我学会了不再依赖 tab 补全,转而使用智能体提示词。现在用的是 Claude,但同样像我经历过的 ChatGPT 时刻一样,我学会了认识它的局限并在局限内工作;慢慢改进我的提示词,也越来越清楚它能做什么、不能做什么。看着人们经历这个过程让我觉得有趣;冗长啰嗦的提示词,更像是愿望清单,但又显得陌生,因为他们懂得如何编程。这与其说是技能问题,不如说是领会如何在它的边界内工作;尽管从某种意义上说,他们的工作方式比我的更是在预判未来。“给 Tasks.tsx 添加日期排序,详情页;使用 shell 系统,参见 components/Shells.tsx,详情模仿 Research.tsx,测试参照 Users.spec.tsx;遵循社区惯例而非我们自己的,避免 mock,使用 stubs.spec.tsx 模式”。
有一天我抬起头,意识到我的提示词方法不再是一个有趣的技巧,而是我现在主要的工作方式。不过代码库仍然完全在我脑中;每一行都经过审查。更多的 PR 导致了请求修改或我自己动手修改。生产力有了相当大的提升,尽管这至少部分是因为我从最终并不喜欢的代码中解脱了出来。Tab 补全很少见。智能体式流程同时让人感到强大、有用和有限。我仍然需要告诉它该做什么,而如果遇到任何棘手的事情,还是得自己动手。
然后 Opus 4.5/6 出现了。描述这种转变会让它听起来比实际更微妙。但突然间,我描述任务所需的粒度,以及我花在手把手指导它们上的时间,都下降了。我的生产力从略好一些,提升到了大约 3 倍(根据几个月内合并的 PR 来衡量)。功能和打磨的水平都提高了,我们在选择交付什么时不再需要那么受限。我脑海中的想法全都倾泻而出,慢慢地变成现实。约束仍然存在;PR 正在成为瓶颈。代码库仍然完全在我脑中,代码行仍然大部分经过审查。我变得更擅长扫读。我开始觉得使用标准库、组件、模式更加重要,因为它让你能够有效地忽略大部分代码变更——只要它们还在轨道上,损害就是有限的,重构也很容易。去寻找更重要的部分。那些包含我们业务独有业务逻辑的部分。那些处理需要人眼审视的客户数据的部分。那些可能不可逆地出问题的部分——数据库变更、加密等。这份工作仍然可以理解,仍然令人愉悦。现在几乎完全是我从重要的事情的角度来思考——架构、迁移计划、关键业务逻辑、系统的目的、保护数据和访问。所有机械无聊的部分都消失了。
在 Opus 5 的推进过程中,更引人注目的是那些更平凡的细节。我能感觉到每个模型都更好了。代码在每一轮中都在慢慢变好。需要纠正的地方更少了。有时候它甚至会纠正我。但这一阶段更多关乎成本。以及它变得多么啰嗦。慢慢地,我开始讨厌应付 Opus,并短暂转向了 ChatGPT。在我使用的场景中,这些模型几乎同样出色,很多时候不相上下。但便宜得多、更自主、也更简洁。我不信任 OpenAI,因此对它抱有偏见,即使它在某些方面更好(它的界面、语音聊天等)。只要 Anthropic 的编程模型差不多好——而在 ChatGPT 5.5 之外它通常更好——我就愿意回去。考虑到利害攸关,我确信 Anthropic 会解决大段文字的问题——毕竟那是我的工作。
然后 Opus 5.5 发布了。我再次感到被冻住,回到原点。我花大量时间在 Twitter 上,看人们在捣鼓什么。为之惊叹;试图理解它。我们再次学习并适应。我的工作方式再次改变。智能体编程……不一样了。告诉模型该做什么,然后检查它的结果……我需要提升。我需要在什么层次上运作?我构建更有野心的副业项目。我复制在一条酷炫推文里看到的东西,并尝试一次成型。我收集了大量垃圾,并产出大量垃圾,比平时还要多。常常感觉像是胡言乱语;但收集想法本身就很有趣。
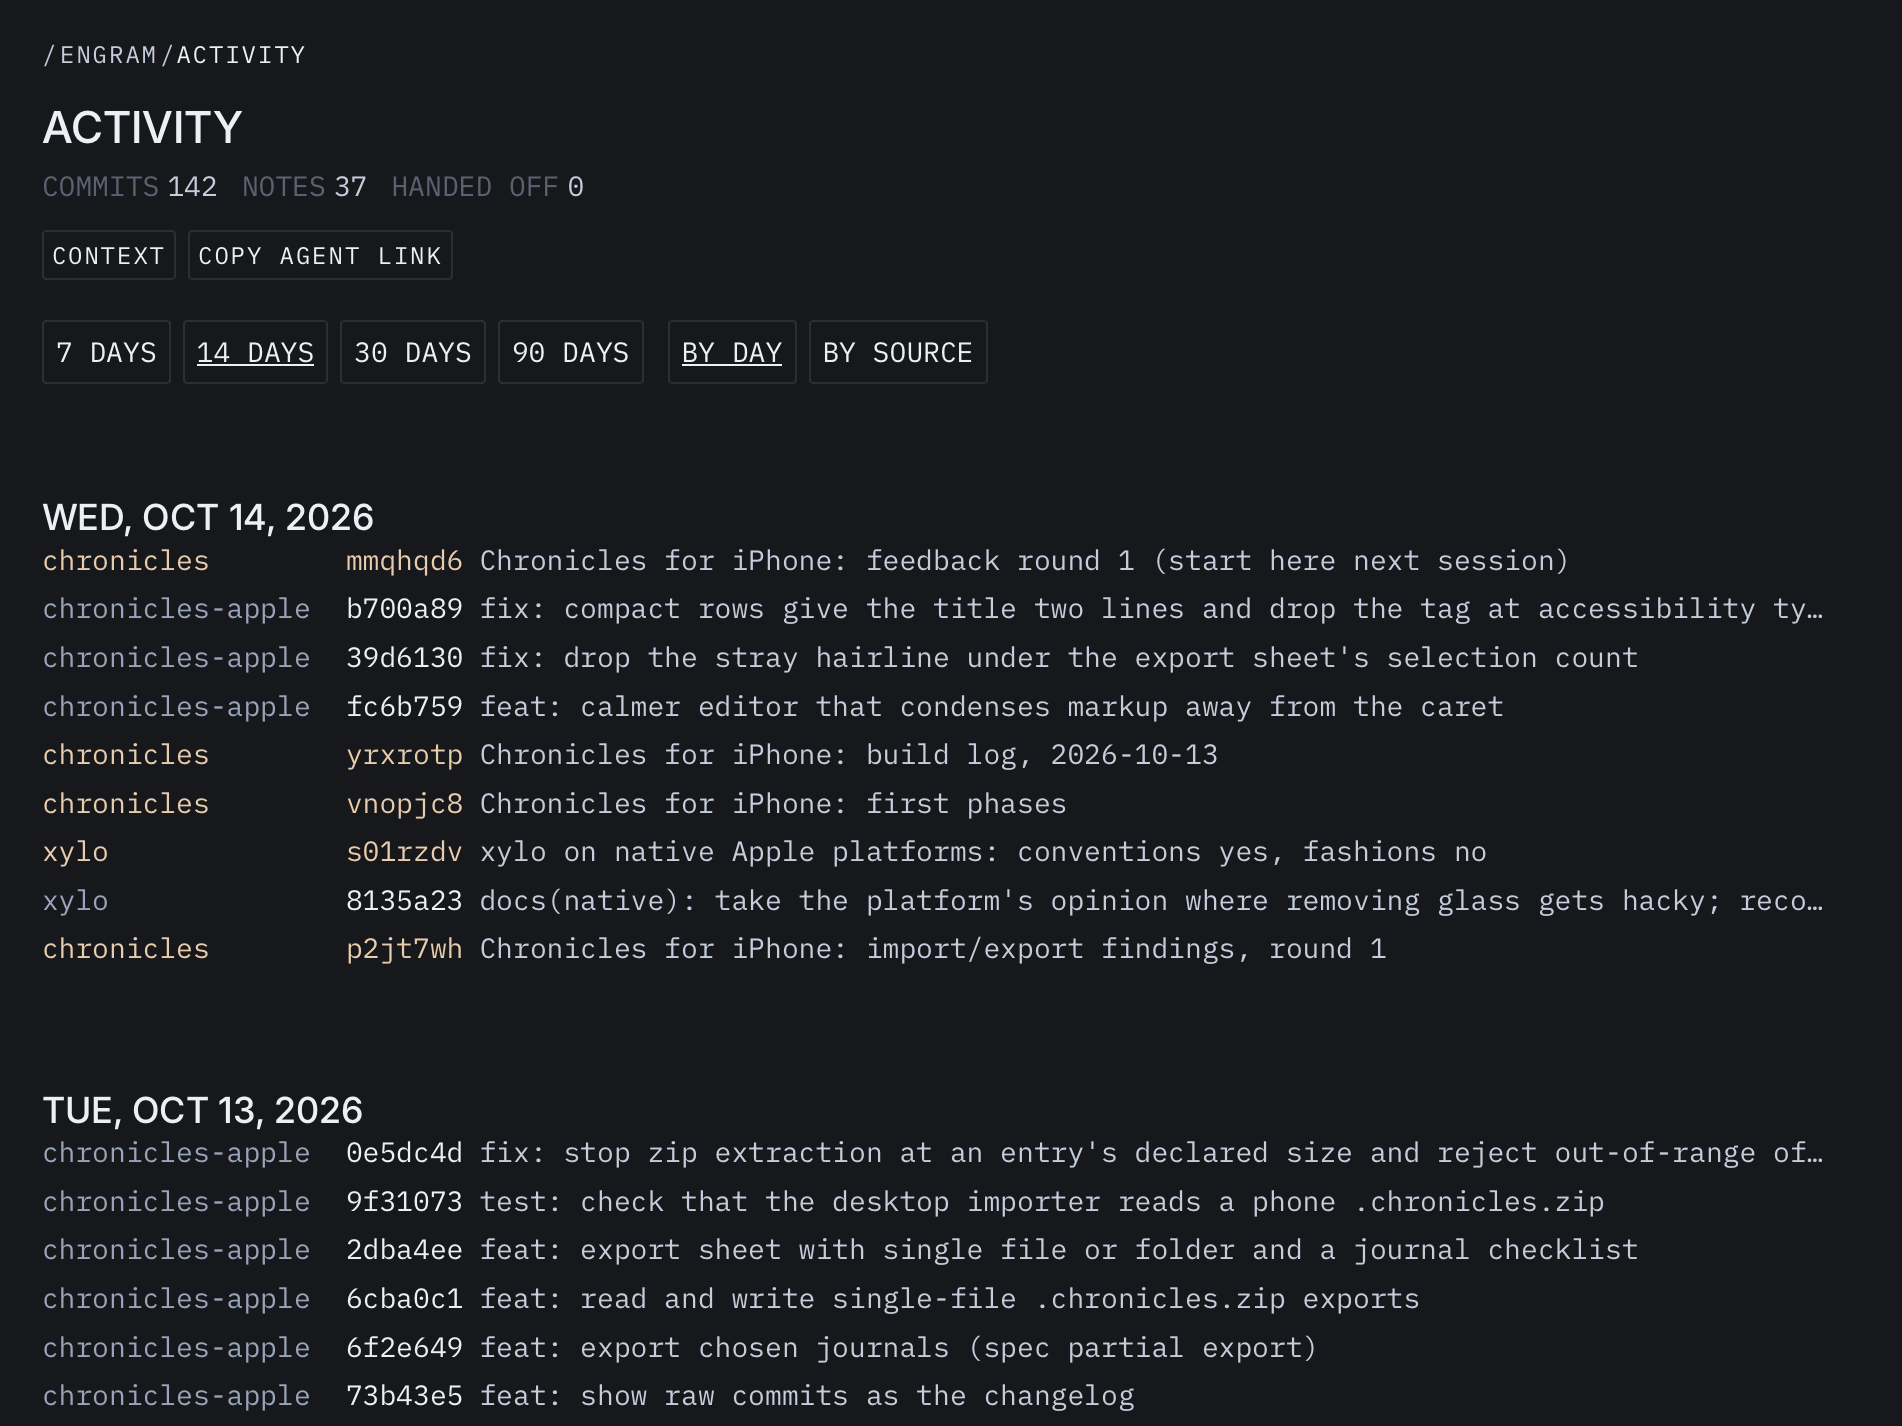
一个统一的活动信息流,让我能更快地查看机器人在我所有项目中的提交和笔记
…
本译文由模型自动生成,仅供参考与快速理解;涉及数字、版本、命令、法律条文等请以原文为准。
正文为原站公开内容的抓取与清洗结果,英文条目附模型生成的中文译文;两者均仅供参考, 准确内容请以原站为准。内容版权归原作者所有,若认为侵权请联系我们下线。